import torchimport載入 PyTorch 工具箱。
from torch import nnfrom … import只拿出 nn(neural network)這個子工具箱,後面寫 nn.Conv2d、nn.Linear。
卷積層吐出來的是一疊「特徵圖」:每張圖有好幾層、每層一個方格。全連結層(nn.Linear)卻只吃「一排數字」。中間要插的就是 B:Flatten,把每張圖的特徵圖攤平成一排。這頁用一個兩層 CNN 在 PyTorch 2.6.0 上實際跑:四個選項哪個成功、哪個出錯、錯誤訊息裡的 896×7 是怎麼來的,再用手寫數字比較 Flatten 和全域平均池化。
nn.Flatten() 把第 0 維以外全部攤平:(4, 32, 7, 7) → (4, 1568),1568=32×7×7。nn.Linear(1568, 10) 要的就是每張圖 1568 個數字;它只看最後一維,不會自動幫你攤平。mat1 and mat2 shapes cannot be multiplied (896x7 and 1568x10);全域平均池化之後也還要 Flatten。torch.flatten(x) 預設連張數也攤平;nn.Linear(7, 10) 剛好對上最後一維時不會報錯,形狀卻是錯的。考卷沒有附程式。本頁用一個常見的兩層 CNN(兩次「卷積→ReLU→最大池化」)處理 4 張 28×28 的灰階圖,輸入用 torch.randn 產生(只看形狀,不需要真的圖)。準確率比較用 scikit-learn 內建的 8×8 手寫數字(1797 張,不用下載)。
本頁所有形狀、錯誤訊息、參數數量和準確率都是在 PyTorch 2.6.0(CPU、Python 3.13.7)上實際執行的結果。
這題的關鍵只有一件事:形狀。只要會讀張量的形狀,四個選項哪個對、哪個會出錯,一眼就看得出來。
PyTorch 把一批圖片存成一個張量(多維的數字陣列),形狀依序是:一次幾張(batch)、每張幾個通道(灰階 1、彩色 3;卷積之後通道數由你決定)、高、寬。
| 形狀 | 意思 |
|---|---|
(4, 1, 28, 28) | 4 張 28×28 的灰階圖(輸入) |
(4, 32, 7, 7) | 4 張圖的特徵圖,每張 32 層、每層 7×7(卷積的輸出) |
(4, 1568) | 4 張圖、每張一排 1568 個數字(Flatten 之後) |
(4, 10) | 4 張圖、每張 10 個類別的分數(全連結層的輸出) |
實測每一層之後的形狀:
輸入        (4, 1, 28, 28)
Conv2d    (4, 16, 28, 28)
ReLU      (4, 16, 28, 28)
MaxPool2d (4, 16, 14, 14)
Conv2d    (4, 32, 14, 14)
ReLU      (4, 32, 14, 14)
MaxPool2d (4, 32, 7, 7)
Conv2d(1, 16, 3, padding=1):16 個 3×3 的濾鏡,padding=1 讓長寬不變,通道變成 16。ReLU 不改形狀。MaxPool2d(2):每 2×2 取最大值,長寬減半。兩輪之後,28→14→7,通道 32。
觀念 1~2 說到張量的形狀,和卷積、池化怎麼把 (4, 1, 28, 28) 變成 (4, 32, 7, 7)。動畫 1 把特徵圖想成「一疊 32 張、每張 7×7 格子的紙」,全連結層想成「只吃一長排數字的機器」,看四個選項怎麼把紙交給機器。
帶著三個問題看:① 1568 是怎麼來的?② 直接接時,全連結層看的是哪一維?③ 全域平均池化之後,為什麼還要 Flatten?
「一疊紙」是比喻;形狀、錯誤訊息和參數數量都是 PyTorch 2.6.0 實際執行的結果。
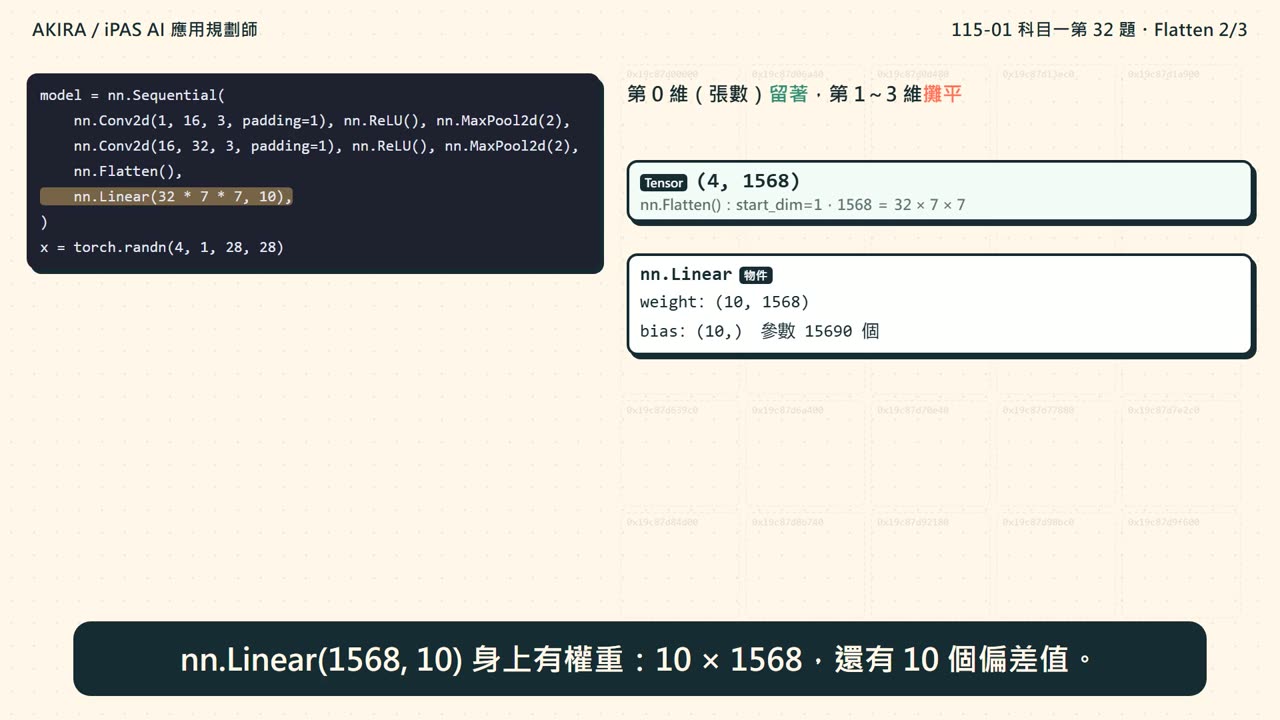
nn.Linear(1568, 10) 裡面有一個 10×1568 的權重矩陣:10 個類別,每一類都對 1568 個輸入各有一個權重,加總後再加偏差值,得到那一類的分數。所以它要的輸入是每張圖一排 1568 個數字,形狀 (張數, 1568)。參數數量:1568×10+10=15690。
它在計算時只看張量的最後一維:最後一維要剛好是 1568。PyTorch 不會猜你的意思、不會自動攤平。
nn.Flatten() 預設 start_dim=1:第 0 維(張數)留著,從第 1 維到最後全部攤平。每張圖的 32 層、每層 7×7,照「第 0 層第一列、第一列的每一格……第 0 層第二列……第 1 層……」的順序排成 1568 個數字。§4 實驗 2 可以點格子看它排到第幾個位置。
nn.Flatten()(fmap).shape       → torch.Size([4, 1568])
fmap.view(fmap.size(0), -1)    → torch.Size([4, 1568])   ← 另一種常見寫法
torch.flatten(fmap, 1)         → torch.Size([4, 1568])   ← 函式版要寫 start_dim=1
把 (4, 32, 7, 7) 直接丟進 nn.Linear(1568, 10),PyTorch 會把前面幾維疊在一起,當成 4×32×7=896 列、每列 7 個數字(最後一維),去和 1568×10 的權重相乘。7 對不上 1568,出錯:
反過來,如果 in_features 剛好等於最後一維(例如 nn.Linear(7, 10)),它不會報錯,而是對每一列各算一次,交回 (4, 32, 7, 10):沒有錯誤訊息的錯誤,最難發現。
觀念 3~5 講了全連結層的權重、Flatten 的 start_dim、形狀對不上的錯誤。動畫 2 跟著 §3 的程式,一層一層看張量的形狀怎麼變,Linear 身上的權重長什麼樣子,最後看兩個「不報錯卻錯了」的陷阱。
帶著三個問題看:① nn.Flatten 的 start_dim 預設是多少?② Linear(1568, 10) 的權重是什麼形狀?③ torch.flatten(x) 不加參數會怎樣?
每一個形狀、權重大小和參數數量,都是 PyTorch 2.6.0 實際執行的結果。
都在 torch.nn 裡(from torch import nn)。每一個都是類別:先用括號做出一層(物件),再把張量丟進去。
| 類別 | 主要參數 | 形狀怎麼變 |
|---|---|---|
nn.Conv2d(in, out, k, padding) | 輸入通道、輸出通道(濾鏡數)、濾鏡大小、補邊 | 通道 in→out;padding=1、k=3 時長寬不變 |
nn.MaxPool2d(2) | 每幾格取一次最大 | 長寬減半(無條件捨去) |
nn.Flatten(start_dim=1, end_dim=-1) | 從第幾維攤平到第幾維(實測預設 1、−1) | (N, C, H, W) → (N, C×H×W) |
nn.Linear(in_features, out_features) | 輸入幾個數、輸出幾個數 | 只改最後一維:in → out |
nn.AdaptiveAvgPool2d(1) | 輸出的長寬(1=全域平均) | (N, C, H, W) → (N, C, 1, 1):還是四維 |
nn.LazyLinear(out) | in_features 第一次執行時自己猜 | 猜的是最後一維;沒攤平就猜成 7 |
通道 × 高 × 寬=32×7×7。改了輸入大小或通道數,in_features 要跟著改;§4 實驗 1 會算給你看。
全域平均池化把每層 7×7 平均成 1 個數,(4, 32, 1, 1);但它還是四維,後面一樣要 Flatten 才能接 Linear(32, 10)。ResNet 就是 avgpool → flatten → fc。
Softmax 把一組分數變成加起來等於 1 的機率,放在最後的分數之後(或交給 CrossEntropyLoss),不是拿來改形狀。
左邊是本頁用的模型,Flatten 在第 7 行。實際執行印出 torch.Size([4, 10])。
import torchfrom torch import nnnn.Sequential(…)nn.Flatten()nn.Linear(32 * 7 * 7, 10)torch.randn(4, 1, 28, 28)兩個實驗的形狀、錯誤訊息和攤平順序,都和 PyTorch 2.6.0 實際執行的結果逐一比對過(§4 下方說明)。
① 實驗 1 把接法換成「C:直接接」,看錯誤訊息的 896x7:896=4×32×7。② 圖片大小換成 32:Flatten 後變成 2048,in_features 也得跟著改。③ 卷積改成 1 輪:(4, 16, 14, 14),攤平是 3136。④ 換成「A:GAP 後直接接」:128x1 對 32x10。
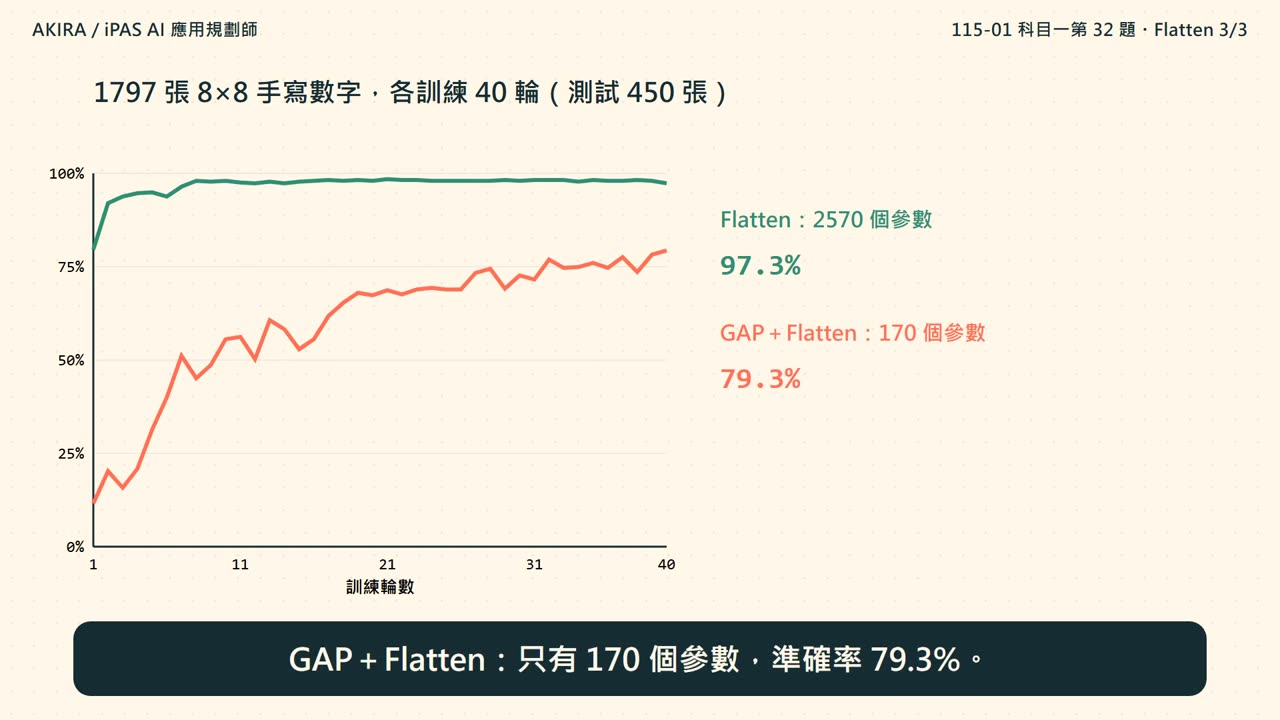
實驗 1 讓你換大小、換接法看形狀。動畫 3 把四個選項在 PyTorch 2.6.0 上各跑一次,看真實的結果和錯誤訊息;再用 1797 張 8×8 手寫數字,比較 Flatten 和 GAP+Flatten 各訓練 40 輪的準確率。
帶著三個問題看:① 錯誤訊息裡的 896x7 和 1568x10 各是什麼?② GAP 讓全連結層的參數變多少?③ 在手寫數字上,GAP+Flatten 的準確率是多少?
錯誤訊息、參數數量和兩條準確率曲線(每一輪的測試準確率),都是 PyTorch 2.6.0 實際執行的結果(random seed 0)。
GAP 把每層平均成一個數:(4, 32, 7, 7) → (4, 32, 1, 1)。但這還是四維,直接接 nn.Linear(32, 10) 會出錯:
要再 Flatten 成 (4, 32) 才行。GAP 是另一種架構選擇(參數從 15690 降到 330),不是「卷積輸出和全連結層之間必要的那一步」。實測在 8×8 手寫數字上:Flatten 版 97.3%、GAP+Flatten 版 79.3%(16 個通道平均掉以後,位置資訊就沒了)。
(4, 32, 7, 7) → (4, 1568),每張圖一排 1568 個數字,剛好是 nn.Linear(1568, 10) 要的;輸出 (4, 10)。
nn.Linear 只看最後一維(7),不會自動攤平。
Softmax 不改形狀,還是 (4, 32, 7, 7),錯誤訊息和 C 一模一樣。實測它只是讓每一格的 32 個通道值加起來等於 1(1.000000),不是拿來接全連結層的。
| 錯誤想法 | 實際上 |
|---|---|
| torch.flatten(x) 和 nn.Flatten() 一樣 | 函式版預設 start_dim=0:(4, 32, 7, 7) → (6272,),連張數都攤平;要寫 torch.flatten(x, 1)。 |
| 沒出錯就代表形狀對了 | nn.Linear(7, 10) 接四維張量不會報錯,交回 (4, 32, 7, 10)。 |
| LazyLinear 會自己處理形狀 | 它只猜 in_features;沒攤平時猜成 7,一樣交回 (4, 32, 7, 10)。 |
| 用了 GAP 就不用 Flatten | GAP 的輸出是 (N, C, 1, 1),還是要攤平成 (N, C)。 |
需要 PyTorch(pip install torch;Google Colab 已經內建)。程式 3 另外要 scikit-learn(Colab 也內建)。
import torch
from torch import nn

torch.manual_seed(0)
features = nn.Sequential(
    nn.Conv2d(1, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
    nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
)
x = torch.randn(4, 1, 28, 28)
h = x
for layer in features:                       # 每一層之後的形狀
    h = layer(h)
    print(f'{type(layer).__name__:10}', tuple(h.shape))
fmap = h                                     # (4, 32, 7, 7)

def run(name, f):
    try:
        print(name, '→', tuple(f().shape))
    except RuntimeError as e:
        print(name, '→ RuntimeError:', e)

run('B Flatten+Linear  ', lambda: nn.Linear(1568, 10)(nn.Flatten()(fmap)))
run('C 直接接 Linear     ', lambda: nn.Linear(1568, 10)(fmap))
run('A GAP 後直接接     ', lambda: nn.Linear(32, 10)(nn.AdaptiveAvgPool2d(1)(fmap)))
run('A GAP+Flatten     ', lambda: nn.Linear(32, 10)(nn.Flatten()(nn.AdaptiveAvgPool2d(1)(fmap))))
run('D Softmax 後接     ', lambda: nn.Linear(1568, 10)(torch.softmax(fmap, dim=1)))
Conv2d     (4, 16, 28, 28)
ReLU       (4, 16, 28, 28)
MaxPool2d  (4, 16, 14, 14)
Conv2d     (4, 32, 14, 14)
ReLU       (4, 32, 14, 14)
MaxPool2d  (4, 32, 7, 7)
B Flatten+Linear   → (4, 10)
C 直接接 Linear      → RuntimeError: mat1 and mat2 shapes cannot be multiplied (896x7 and 1568x10)
A GAP 後直接接      → RuntimeError: mat1 and mat2 shapes cannot be multiplied (128x1 and 32x10)
A GAP+Flatten      → (4, 10)
D Softmax 後接      → RuntimeError: mat1 and mat2 shapes cannot be multiplied (896x7 and 1568x10)
import torch
from torch import nn

fmap = torch.randn(4, 32, 7, 7)

print(nn.Flatten()(fmap).shape)              # 預設 start_dim=1:保留第 0 維(張數)
print(torch.flatten(fmap).shape)             # 函式版預設 start_dim=0:連張數都攤平了
print(torch.flatten(fmap, 1).shape)          # 要寫 start_dim=1 才對
print(fmap.view(fmap.size(0), -1).shape)     # 另一種常見寫法

print(nn.Linear(7, 10)(fmap).shape)          # 只看最後一維:不報錯,形狀卻不是 (4, 10)
lazy = nn.LazyLinear(10)
print(lazy(fmap).shape, lazy.in_features)    # LazyLinear 也一樣:猜成 in_features=7
torch.Size([4, 1568])
torch.Size([6272])
torch.Size([4, 1568])
torch.Size([4, 1568])
torch.Size([4, 32, 7, 10])
torch.Size([4, 32, 7, 10]) 7
最後兩行都沒有報錯,形狀卻是 (4, 32, 7, 10)。LazyLinear 執行時還會印一則「Lazy modules 還在開發中」的提醒(UserWarning),這裡省略。
import numpy as np
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

d = load_digits()                                                      # 1797 張 8×8 手寫數字
X = torch.tensor(d.images / 16.0, dtype=torch.float32).unsqueeze(1)     # (1797, 1, 8, 8)
y = torch.tensor(d.target)
tr, te = train_test_split(np.arange(len(y)), test_size=0.25, random_state=0, stratify=d.target)

def make(head):
    torch.manual_seed(0)
    body = nn.Sequential(nn.Conv2d(1, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2))   # → (16, 4, 4)
    if head == 'Flatten':
        return nn.Sequential(body, nn.Flatten(), nn.Linear(16 * 4 * 4, 10))
    return nn.Sequential(body, nn.AdaptiveAvgPool2d(1), nn.Flatten(), nn.Linear(16, 10))

for head in ('Flatten', 'GAP+Flatten'):
    m = make(head)
    opt = torch.optim.Adam(m.parameters(), lr=0.01)
    g = torch.Generator().manual_seed(0)
    for epoch in range(40):
        m.train()
        perm = tr[torch.randperm(len(tr), generator=g).numpy()]
        for i in range(0, len(perm), 64):
            b = perm[i:i + 64]
            opt.zero_grad()
            nn.functional.cross_entropy(m(X[b]), y[b]).backward()
            opt.step()
    m.eval()
    with torch.no_grad():
        acc = (m(X[te]).argmax(1) == y[te]).float().mean().item()
    print(f'{head}:全連結層 {sum(p.numel() for p in m[-1].parameters())} 個參數,測試準確率 {acc:.4f}')
Flatten:全連結層 2570 個參數,測試準確率 0.9733
GAP+Flatten:全連結層 170 個參數,測試準確率 0.7933
nn.Flatten():(4, 32, 7, 7) → (4, 1568)(答案 B)。mat1 and mat2 shapes cannot be multiplied;GAP 之後還是要 Flatten。torch.flatten(x) 的預設 start_dim=0,和「沒報錯但形狀錯」的 Linear(7, 10)。每一頁都把考古題的程式一行一行拆開:記憶體裡發生什麼、每個選項各算出什麼,配旁白動畫。完整版還有: