從 scikit-learn 內建的資料集借出 load_digits 函式,呼叫它,交回一個資料包,名牌 digits。
執行後(實測):
digits → Bunch(資料包),裡面有 data、target、images、target_names、DESCR…
digits.data 形狀 (1797, 64),dtype float64,值 0~16
digits.target 前 10 個:0 1 2 3 4 5 6 7 8 9
第 46 題替手寫數字加上雜訊,再用 PCA 降噪,結果圖還是很花。這頁先用「樣板」講 PCA 在做什麼,再逐行拆開 fit、transform、inverse_transform。實測 PCA() 會把 64 個主成分全部留下,組回來的圖和 noisy 最多只差 0.00000000000006;改成只留 12 個,和乾淨圖的誤差從 16.01 降到 7.25。
digits.data 是 1797 列 × 64 欄的表np.random.normal(digits.data, 4):每個像素各自加上「標準差 4」的隨機雜訊(實測和乾淨圖的誤差 16.01)fit 學樣板、transform 算用量、inverse_transform 組回圖PCA() 的 n_components 是 None,等於 64 個全留,組回來和 noisy 一模一樣,所以要改的是程式碼 BPCA(0.50) 自動留 12 個(7.25);KNN 準確率從 0.8581 升到 0.8742郵遞區號自動辨識的研究:一份手寫數字影像資料集,每張是 8×8 的灰階圖片,來自 UCI Machine Learning Repository。研究人員發現資料裡可能有雜訊(筆跡模糊、干擾點),想先降噪,再用 KNN 搭配交叉驗證評估分類效果(第 47 題)。

先憑直覺選一個,讀完再回來對照(附圖還有程式碼 E,但選項只有 A~D):
PCA 降噪靠的是丟掉後面那些很小的成分(雜訊多半在那裡)。PCA() 沒指定 n_components,什麼都沒丟,inverse_transform 組回來的就是 noisy 本身。要改的是建立 PCA 的那一行,例如 PCA(n_components=0.50) 或 PCA(n_components=12)。
先看一張手寫數字在電腦裡長什麼樣子、雜訊怎麼加上去;再用「樣板」講 PCA,最後看 n_components 為什麼決定了有沒有降噪。中間有兩支動畫,每支前後都有文字說明。
第 3 支動畫(四個選項逐一檢查、留幾個最好)放在 §4,和互動工具一起看。
電腦裡的灰階圖,就是一格一格的數字:這份資料 0 是白、16 是最黑。第一張圖(數字 0)的 64 個像素,實際是:
load_digits() 交回一個資料包(Bunch),裡面的 digits.data 把每張圖攤平成一列 64 個數字,共 1797 張,形狀 (1797, 64);digits.target 是每張圖的正確答案(0~9);digits.images 是沒攤平的版本,形狀 (1797, 8, 8)。
np.random.normal(digits.data, 4):每個像素各加一點雜訊digits.data4結果是同樣形狀 (1797, 64) 的新陣列,原本的 digits.data 沒有被改。實測(種子 42):第一個像素 0 變成 1.9869;全部的值從 −17.85 到 31.92,跑出 0~16 的範圍;和乾淨圖的平均平方誤差(MSE)是 16.01,差不多就是 4²。
題目沒有固定亂數種子,每次執行的雜訊都不一樣。本頁所有數字都在這行前面加了 np.random.seed(42),讓你跑出同一份。
PCA(主成分分析)從 1797 張圖裡,找出變化最大的方向:第 1 個方向最能區分這些圖、第 2 個次之……一共 64 個。把每個方向畫成 8×8,就像一張「筆畫樣板」:
由 noisy 學出來的平均圖和前 6 個主成分(藍=正、橘=負)。
任何一張圖都可以寫成「平均圖 + 係數₁ × 樣板₁ + 係數₂ × 樣板₂ + …」。第一張雜訊 0 的前 5 個係數,實測是 −9.83、−19.6、3.49、−15.19、9.68。只用前幾個樣板,就只留下大方向(筆畫的形狀),細碎的變化(多半是雜訊)就被丟掉了。
| 方法 | 做什麼 | 交回什麼(實測形狀) |
|---|---|---|
pca.fit(noisy) | 從 noisy 學出平均圖和樣板,記在 pca 身上 | pca 自己;身上多了 mean_ (64,)、components_ (64, 64) |
pca.transform(noisy) | 每張圖算出「每個樣板用多少」 | 係數表 (1797, 64) |
pca.inverse_transform(係數) | 平均圖 + 係數 × 樣板,組回圖 | 圖 (1797, 64) |
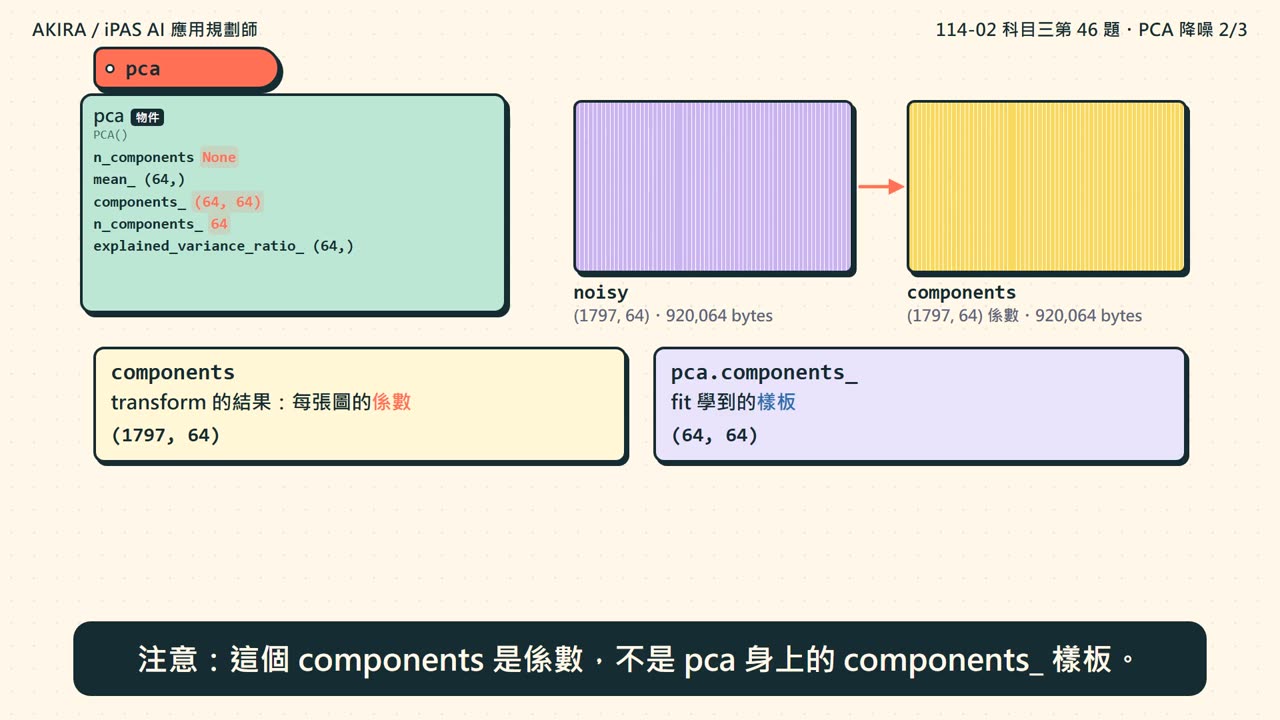
題目把 transform 的結果取名 components(每張圖的係數,1797 × 64);PCA 身上的 components_(後面有底線)才是樣板(64 × 64)。實測兩者不是同一個東西。
n_components:要留幾個樣板| 寫法 | 意思 | 這題實測留下 |
|---|---|---|
PCA()(預設 None) | 全部留下:樣本數和特徵數取小的 | 64 個 |
PCA(n_components=12) | 整數:留前 12 個 | 12 個 |
PCA(n_components=0.50) | 0~1 的小數:留到累積解釋 50% 的變異為止 | 12 個(51.5%) |
每個主成分「解釋」了多少變化,記在 explained_variance_ratio_。實測累積:前 1 個 8.8%、前 5 個 33.2%、前 12 個 51.5%、前 32 個 76.3%、64 個 100%。手寫筆畫的變化集中在前面;雜訊則平均灑在所有方向,所以只留前面幾個,能留住大部分筆畫、丟掉大部分雜訊。
64 個像素的圖,用 64 個樣板一定能完整組回來(就像 64 塊積木拼回原本的 64 格)。所以 PCA() 之後再 inverse_transform,組回來的就是 noisy 本身:
這就是題目說「影像仍然含有明顯的雜訊」的原因:問題出在程式碼 B,fit、transform、inverse_transform 本身都沒錯。
觀念 3~6 用文字講了「平均圖 + 係數 × 樣板」。動畫 1 把它畫出來:先看一張 0 怎麼變成 64 個數字、怎麼加上雜訊;再看 PCA 學到的平均圖和樣板,把雜訊 0 用 1、2、5、12、64 張樣板分別組回來,最後看 1797 張全部算出來的誤差曲線。
帶著三個問題看:① 一張圖怎麼寫成「平均圖 + 樣板」?② 用 12 張和用 64 張組回來,差在哪裡?③ 為什麼 64 張全用就等於沒降噪?
看的時候注意:樣板裡藍色是正、橘色是負。
平均圖、樣板、係數和每一個誤差,都是 scikit-learn 1.8 用種子 42 的雜訊實際算出來的。
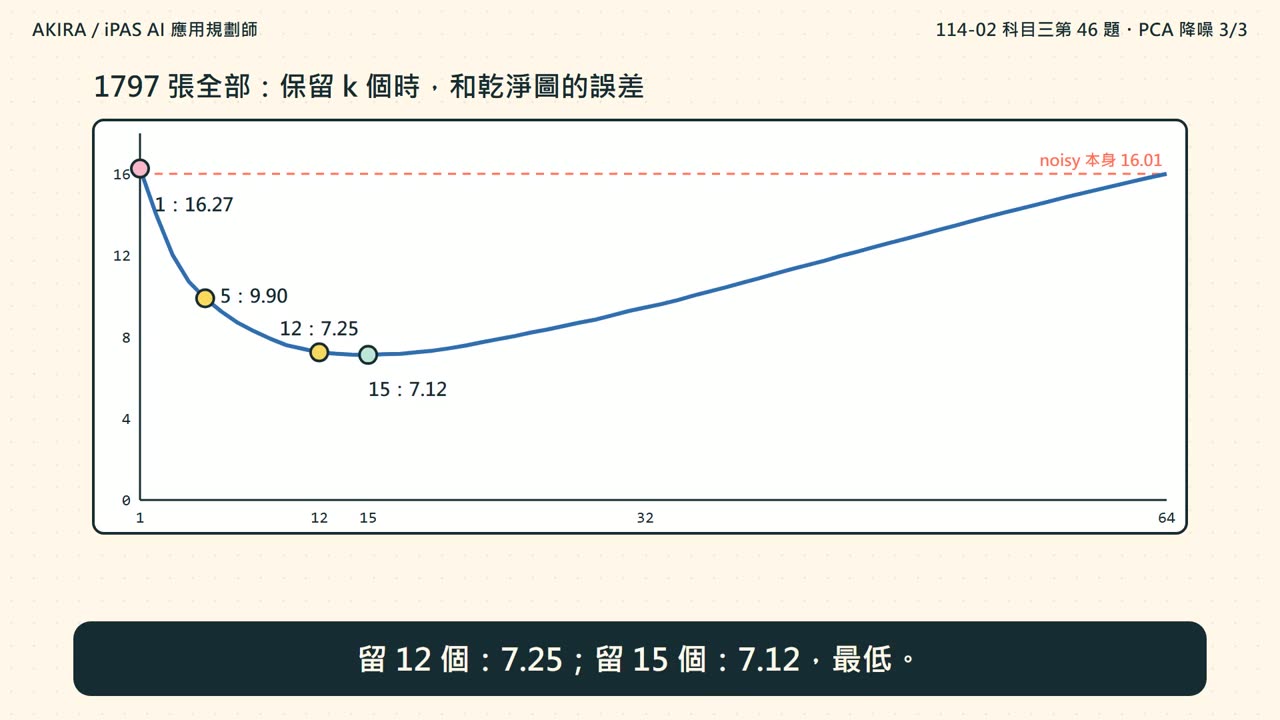
transform 算出來的數字,例如雜訊 0 的前兩個是 −9.83、−19.6。PCA() 的 n_components 是 None,預設就是全部留下。拿重建的圖和乾淨的圖比,算平均平方誤差(越小越乾淨)。1797 張全部實測:
| 保留幾個 | 累積解釋變異 | 和乾淨圖的誤差 | 說明 |
|---|---|---|---|
| 1 | 8.8% | 16.27 | 只剩一個大方向,連數字都認不出來 |
| 5 | 33.2% | 9.90 | 形狀出來了,還有點糊 |
| 12 | 51.5% | 7.25 | PCA(0.50) 選的 |
| 15 | 56.5% | 7.12 | 這份資料最低 |
| 32 | 76.3% | 9.45 | 雜訊開始跟著回來 |
| 64 | 100% | 16.01 | PCA():和 noisy 一樣 |
留太少,筆畫也被丟掉;留太多,雜訊跟著回來。誤差像一個 U 字,中間最低。對後面的分類也有幫助:用第 47 題的 KNN(3 個鄰居)做 5 折交叉驗證,實測準確率乾淨圖 0.9666、有雜訊 0.8581、PCA 留 12 個後 0.8742。
降噪不保證分類一定變好:同一份資料改用 KNN 的預設 5 個鄰居,實測有雜訊 0.8804、PCA(0.50) 之後 0.8731,反而低了一點。實務上要用驗證資料自己比。
PCA(sklearn.decomposition)numpy.ndarraypca(fit 之後身上有 mean_、components_、n_components_)noisy、components、filtered(三個 1797 × 64 的陣列).fit() → .transform() → .inverse_transform()觀念 4~7 講了三個方法和 n_components。動畫 2 打開記憶體:剛做好的 pca 身上有什麼、fit 之後多了哪些屬性、transform 和 inverse_transform 各做出哪一塊新陣列,最後換成 PCA(n_components=0.50),看身上的東西怎麼變。
帶著三個問題看:① fit 之後,n_components 和 n_components_ 各是多少?② components 和 components_ 差在哪裡?③ 改成 0.50 之後,係數剩幾個?
屬性、形狀、bytes 和最大差,都取自實際執行(Python 3.13.7、NumPy 2.4.3、scikit-learn 1.8.0)。
n_components 還是你給的設定 None;n_components_(後面有底線)是 fit 之後實際留下的個數 64。components 和 components_ 差在哪裡?components 是題目自己取的名字,放 transform 的結果:每張圖的係數 (1797, 64)。pca.components_ 是 fit 學到的樣板 (64, 64)。transform 交回 (1797, 12),components_ 只剩 (12, 64)。組回來還是 (1797, 64) 的圖,但後面 52 個方向的雜訊沒了。PCA 在 scikit-learn 裡屬於轉換器(transformer):不預測答案,而是把資料換成另一種樣子。所有轉換器都是同一個套路:
PCA(…)_實測:剛做好的 PCA() 身上還沒有 components_(hasattr 是 False),fit 之後才有;fit 交回 pca 自己,所以可以接著寫 PCA(0.50).fit(noisy)。fit_transform(noisy) 是 fit 加 transform 的簡寫。
| PCA 的參數 | 預設(實測 get_params()) | 白話 |
|---|---|---|
n_components | None | 留幾個主成分;None = 全部(這題的問題) |
whiten | False | 要不要把每個係數縮放成同樣大小;降噪不用開 |
svd_solver | 'auto' | 用哪一種算法求主成分,交給 scikit-learn 自動選 |
random_state | None | 只有隨機算法才用得到 |
copy | True | fit 時不改動你傳進去的資料 |
第 1~13 行是原題(第 6 行是本頁加的亂數種子;原題第 3 行在 Jupyter 裡不用 print 就會顯示)。後面補了幾行,檢查有沒有降噪,再改成只留一部分主成分。左邊是完整程式(點任一行可以跳到解說),右邊往下捲時,左邊會自動標出目前講到哪一行。手機上會改成上下排列。
從 scikit-learn 內建的資料集借出 load_digits 函式,呼叫它,交回一個資料包,名牌 digits。
1797 張圖,每張 64 個像素。.shape 是陣列的屬性(不用加括號)。原題在 Jupyter 直接寫 digits.data.shape,最後一行的值會自動顯示。
載入 NumPy;第 6 行是本頁加的:固定亂數起點,每個人跑出同一份雜訊。
以每個像素原本的值為中心、標準差 4,各抽一個隨機數,做成新陣列,名牌 noisy。
np.random.normal(loc, scale, size)。digits.data4從 scikit-learn 的「分解」工具箱借出 PCA 這張設計圖(類別)。這行沒有問題。
照設計圖做一個 PCA 物件,全部用預設值,名牌 pca。
n_components 不設,這題會留下全部 64 個,資料一點都沒少。PCA(n_components=0.50)(留到 50% 變異,實測 12 個)或直接寫 PCA(n_components=12)。從 1797 張雜訊圖學出平均圖和 64 個主成分,記在 pca 身上。
用 noisy 來 fit 是對的:真實情況裡我們手上只有含雜訊的資料。
注意名字:這個 components 是係數,不是 pca.components_(樣板)。64 個係數全部算出來,一個都沒丟。
平均圖 + 64 個係數 × 64 個樣板,組回 1797 張圖。
最大差 0.00000000000006,只是電腦的捨入誤差:組回來的就是 noisy。
前 12 個主成分累積解釋 51.5% 的變異,剛好超過 50%,所以留 12 個。.fit() 交回物件自己,才能接在 PCA(…) 後面寫。
noisy 和乾淨圖的誤差 16.01;只留 12 個組回來後是 7.25,少了一半以上:這才是降噪。
拖動滑桿,看 10 張數字(0~9 各一張)用前 k 個主成分組回來的樣子。平均圖和主成分是 Python 用 noisy(種子 42)實際 fit 出來的,網頁只做「平均 + 係數 × 樣板」;每一個 k 的結果都和 scikit-learn 1.8 對過(64 種 k,每個像素差不到 0.001)。
PCA() 的情況。上面的工具讓你自己拖 k。動畫 3 把題目的五行程式一行一行檢查,說明為什麼只有程式碼 B 要改;再看 1797 張的誤差曲線,最後用第 47 題的 KNN 看降噪對分類有多少幫助。
帶著三個問題看:① 為什麼 C、D、E 都不用改?② PCA(0.50) 為什麼選到 12 個?③ 降噪之後,KNN 準確率回到乾淨圖的水準了嗎?
誤差曲線是 1797 張、k=1~64 逐一實測;準確率是 KNN(n_neighbors=3)5 折交叉驗證的平均。
PCA(0.50) 為什麼選到 12 個?from sklearn.decomposition import PCA 不用改只是借出 PCA 設計圖,和降噪效果無關。
pca = PCA() 正解:要改這行n_components 預設 None,留下全部 64 個主成分;組回來和 noisy 只差 5.9×10⁻¹⁴。改成 PCA(n_components=0.50)(留 12 個)後,和乾淨圖的誤差從 16.01 降到 7.25。
pca.fit(noisy) 不用改用含雜訊的資料學主成分是正常做法;我們手上本來就只有 noisy。
components = pca.transform(noisy) 不用改算係數這一步沒錯;要丟掉多少成分,是在建立 PCA 時就決定的。程式碼 E 的 inverse_transform 也一樣不用改。
不設 n_components 就什麼都沒丟,inverse_transform 會把雜訊原封不動組回來。
下面的程式用同一份雜訊(種子 42),比較保留 1~64 個主成分的誤差,確認 PCA() 留了幾個,最後用第 47 題的 KNN 做 5 折交叉驗證。只需要 scikit-learn,複製到 Google Colab 就能執行。
import numpy as np
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import cross_val_score

digits = load_digits()
X, y = digits.data, digits.target
np.random.seed(42)                       # 固定雜訊,結果才能對照
noisy = np.random.normal(X, 4)

def mse(a, b):                           # 和乾淨的圖差多少(越小越乾淨)
    return ((a - b) ** 2).mean()

print(f'雜訊圖和乾淨圖的誤差:{mse(noisy, X):.2f}')

# 1. 保留不同個數的主成分,重建後和乾淨的圖比
for n in [1, 5, 12, 15, 32, 64]:
    pca = PCA(n_components=n).fit(noisy)
    filtered = pca.inverse_transform(pca.transform(noisy))
    kept = pca.explained_variance_ratio_.sum()
    print(f'保留 {n:>2} 個:解釋 {kept:6.1%} 的變異,誤差 {mse(filtered, X):5.2f}')

# 2. 題目的寫法 PCA():留幾個?組回來和 noisy 差多少?
pca = PCA().fit(noisy)
filtered = pca.inverse_transform(pca.transform(noisy))
print('PCA() 保留', pca.n_components_, '個,和 noisy 最大差', np.abs(filtered - noisy).max())

# 3. 用 KNN(第 47 題的模型)做 5 折交叉驗證,看分類準確率
knn = KNeighborsClassifier(n_neighbors=3)
pca12 = PCA(n_components=12).fit(noisy)
denoised = pca12.inverse_transform(pca12.transform(noisy))
for name, data in [('乾淨', X), ('有雜訊', noisy), ('PCA 12 個', denoised)]:
    print(f'{name}:準確率 {cross_val_score(knn, data, y, cv=5).mean():.4f}')
在 Python 3.13.7、NumPy 2.4.3、scikit-learn 1.8.0 實際執行:
雜訊圖和乾淨圖的誤差:16.01
保留  1 個:解釋   8.8% 的變異,誤差 16.27
保留  5 個:解釋  33.2% 的變異,誤差  9.90
保留 12 個:解釋  51.5% 的變異,誤差  7.25
保留 15 個:解釋  56.5% 的變異,誤差  7.12
保留 32 個:解釋  76.3% 的變異,誤差  9.45
保留 64 個:解釋 100.0% 的變異,誤差 16.01
PCA() 保留 64 個,和 noisy 最大差 5.861977570020827e-14
乾淨:準確率 0.9666
有雜訊:準確率 0.8581
PCA 12 個:準確率 0.8742
| 新出現的語法 | 是什麼 | 白話 |
|---|---|---|
def mse(a, b): | 自己定義函式 | 把「相減、平方、平均」包成一個名字,下面重複用 |
pca.explained_variance_ratio_.sum() | 屬性+方法 | 留下的主成分一共解釋了多少變化 |
f'{kept:6.1%}' | f-string 格式 | 佔 6 格、用百分比、小數 1 位 |
for name, data in [(…), (…)] | 拆包 | 每次拿出一組「名字、資料」 |
cross_val_score(knn, data, y, cv=5) | scikit-learn 函式 | 5 折交叉驗證,交回 5 個分數(第 47 題會細講) |
digits.data 是 (1797, 64)。np.random.normal(digits.data, 4):以原像素為中心、標準差 4 加雜訊,誤差 16.01。fit 學樣板、transform 算係數、inverse_transform 組回圖。PCA() 的 n_components 是 None → 留下 64 個 → 組回來就是 noisy。答案 (B)。PCA(n_components=0.50):留 12 個,誤差 7.25;留太少筆畫也不見,留太多雜訊又回來。components(transform 的結果,係數)和 pca.components_(樣板)是兩個不同的東西。PCA(n_components=0.9) 這題會留幾個?pca.fit(digits.data)(用乾淨資料學)可以嗎?n_components 還是 None,照樣 64 個全留。fit 和 transform 可以合成一行嗎?components = pca.fit_transform(noisy),結果和分開寫一樣。每一頁都把考古題的程式一行一行拆開:記憶體裡發生什麼、每個選項各算出什麼,配旁白動畫。完整版還有: