兩個都是 Python 內建的標準函式庫,不用另外安裝。
import math模組要用裡面的
math.dist。import random模組要用裡面的
random.sample(隨機挑)和 random.seed(固定亂數)。這題又是一段虛擬碼:給它一堆資料點和「要分成幾群」X,它先隨機挑 X 個點當中心,再反覆做兩件事:把每個點分給最近的中心、把每個中心搬到它那一群的平均位置,直到中心不再移動。答案是 A:K-means,名字裡的 means 就是「平均」。這頁用「12 間店要蓋 3 個物流中心」把每一步演出來,把虛擬碼逐行翻成 Python,和 scikit-learn 的 KMeans 對答案;最後把四個選項放在同一張地圖上,看它們分群的想法差在哪。
random.sample、math.dist、distances.index(min(distances))、zip、while True 加 break;和 scikit-learn 用同樣的起點,也是 4 輪、同樣的答案。
先憑直覺選一個,讀完再回來對照:
① Input 只有資料和群數,沒有標籤:這是非監督式的分群。② 群數 X 要先給:演算法不會自己決定分幾群。③ 隨機選 X 個點當初始中心:每一群用一個「中心點」代表。④ 指派給最近的中心:每個點只屬於一群,非此即彼。⑤ 中心更新為平均值、重複到不再變動:K 個中心、每個都是平均(mean),就是 K-means 名字的由來。
考卷只有虛擬碼,沒有資料。本頁自己設計了一份教學資料:一張 10 × 10 公里的地圖上有 12 間店,要蓋 3 個物流中心(X=3)。每間店由最近的物流中心送貨;物流中心想蓋在它負責的店的正中央,送貨距離最短。西南、東邊、北邊各有 4 間店。
本頁所有數字、輸出都是在 Python 3.13.7、scikit-learn 1.8.0(NumPy 2.4.3、SciPy 1.16.2)上實際執行的結果。
這題一樣不考語法,考的是看懂流程。下面先講什麼是分群、中心和平均,中間兩支動畫:一支在地圖上把 4 輪演一次,一支把虛擬碼翻成 Python、打開記憶體一行一行跑。
第 40 題的資料有正確答案(考了幾分),模型學的是「怎麼預測答案」。分群不一樣:資料沒有標籤,演算法只看資料彼此之間的距離,把靠得近的放成一群。這叫非監督式學習。
本頁的例子:12 間店只有位置 (x, y),沒有人告訴你哪間屬於哪一區。要蓋 3 個物流中心,就要先把 12 間店分成 3 群,再決定每個物流中心蓋在哪裡。
| 區域 | 4 間店的位置(公里) |
|---|---|
| 西南 | (1.5, 2) (2, 1) (2.5, 3) (1, 3.5) |
| 東邊 | (7, 2.5) (8, 1.5) (8.5, 3) (7.5, 4) |
| 北邊 | (4, 8) (5, 9) (5.5, 7.5) (3.5, 7) |
表格是給讀者看的;演算法拿到的只是 12 組數字,不知道「西南、東邊、北邊」。
距離用直線距離:math.dist((1.5, 2), (1, 3.5)) 實測是 1.5811388300841898(√(0.5² + 1.5²))。中心(centroid)是代表一群的那一個點。一群點的平均位置,就是 x 取平均、y 取平均:西南 4 間店的平均是 ((1.5+2+2.5+1) ÷ 4, (2+1+3+3.5) ÷ 4) = (1.75, 2.375)。
為什麼物流中心要蓋在平均位置?因為在所有可能的位置裡,平均位置到這群店的「距離平方」總和最小。K-means 每一輪做的事,就是讓這個總和(scikit-learn 叫 inertia_)一路變小。本頁最後的答案:總和 14.125。
K-means 只有兩個動作輪流做。a. 分群:物流中心位置先不動,每間店找最近的中心報到。b. 更新中心:店的分組先不動,每個中心搬到它那群店的平均位置。搬家之後,有些店會發現「隔壁那個中心比較近」,下一輪就換組;換組之後中心又要再搬……直到中心不再移動。
| 輪 | 這一輪開始時的 3 個中心(實測,random.seed(3)) | 分群結果 |
|---|---|---|
| 1 | (1, 3.5) (5, 9) (4, 8):隨機挑的 3 間店,有 2 間在北邊 | 西南 4 間+東邊 2 間擠到第 0 群 |
| 2 | (3.67, 2.25) (5.25, 8.25) (5.88, 5.5) | 東邊的 (7, 2.5) 換到第 2 群 |
| 3 | (3.0, 2.2) (4.5, 7.88) (7.67, 3.17) | 東邊 4 間都到第 2 群了 |
| 4 | (1.75, 2.38) (4.5, 7.88) (7.75, 2.75) | 沒人換組,算出來的新中心和舊的一樣 → 停止 |
觀念 1~3 說到:分群沒有標籤、中心是一群的平均、K-means 只有兩個步驟輪流做。動畫 1 直接在地圖上演:隨機挑 3 間店當物流中心的起點,每間店找最近的中心報到,中心搬到那群店的平均位置,一輪一輪,直到中心不再移動;最後再看一個不好的起點。
帶著三個問題看:① 第 1 輪為什麼東邊的店被分到西南的中心?② 跑了幾輪才停?③ random.seed(7) 的起點為什麼停在壞答案?
12 間店是本頁自己設計的教學資料(考卷沒有資料)。每一輪的中心、分群和總和,都是 Python 3.13.7 照 §3 的程式實際執行的結果(random.seed(3) 和 random.seed(7)),和 scikit-learn 1.8.0 的 KMeans 一致。
| 虛擬碼 | Python | 第 1 間店 (1.5, 2) 在第 1 輪(實測) |
|---|---|---|
| 計算它到每個中心的距離 | [math.dist(p, c) for c in centroids] | [1.58…, 7.83…, 6.5] |
| 指派給距離最近的中心 | distances.index(min(distances)) | min 是 1.58…,它在第 0 號 → 第 0 群 |
| 該群中所有的資料點 | [p for p, c in zip(data_points, clusters) if c == k] | zip 把「店」和「它的群號」一對一配起來,只留群號是 k 的 |
| 計算平均值 | sum(x for x, y in members) / len(members) | 第 0 群有 6 間店,x 的平均 3.6666666666666665 |
群編號從 0 開始:X=3 時,群號是 0、1、2,正好是 centroids 清單裡中心的位置。
虛擬碼說「重複直到收斂」「中心不再變動時停止」,但事先不知道要幾輪。Python 寫成 while True:(一直重複),在迴圈裡檢查 if new_centroids == centroids: break,一樣就跳出。
不過,停下來不代表找到最好的分法。起點是隨機挑的:random.seed(7) 挑到 (8, 1.5)、(2.5, 3)、(8.5, 3),兩個中心都在東邊,第 2 輪就停了,答案卻是「東邊切兩半、西南和北邊硬湊一群」,距離平方總和 87.25(好的分法是 14.125)。實測換 100 個種子,91 個找到好的分法、9 個卡在壞的分法。這叫局部最佳。
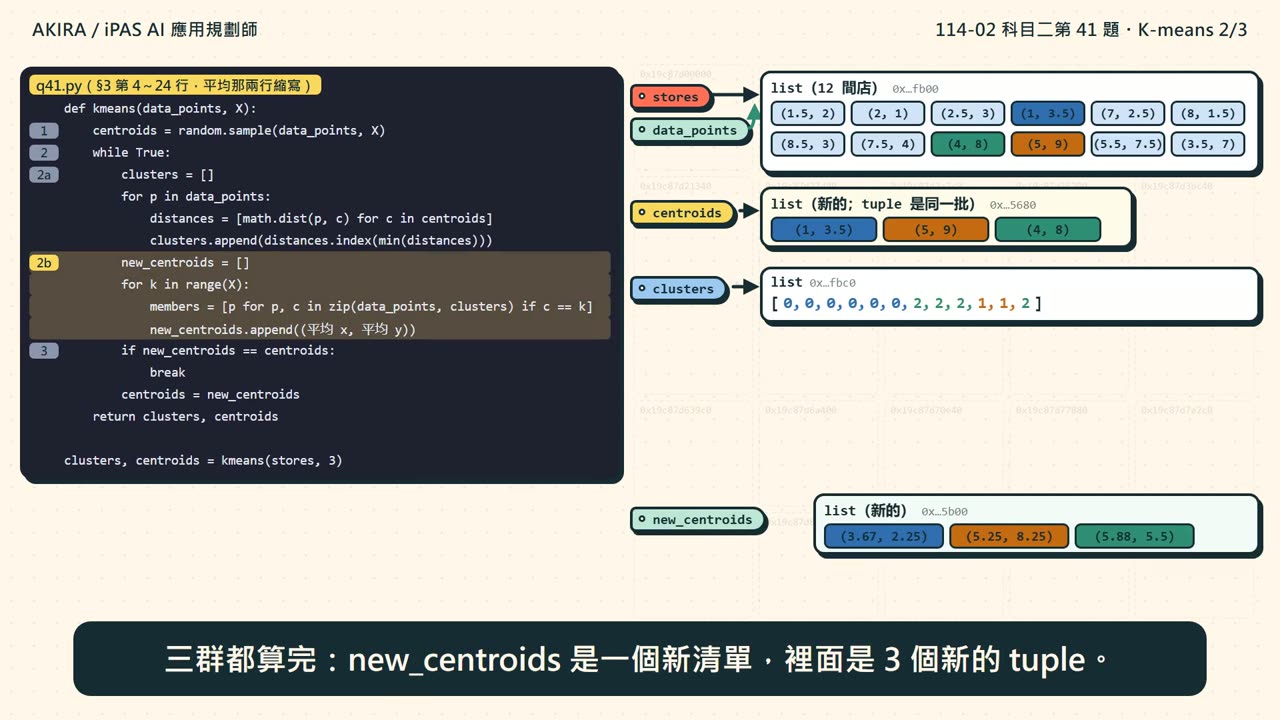
觀念 4~5 講了找最近的那一個、用 zip 收集同一群、while True 加 break。動畫 2 左邊是 §3 的 kmeans,執行到哪一行就亮哪一行;右邊打開記憶體:stores 這個清單、random.sample 做出來的 centroids、每一輪新做的 clusters 和 new_centroids。
帶著三個問題看:① random.sample 有沒有複製那 3 間店?② distances.index(min(distances)) 交回什麼?③ 什麼時候 break?
畫面上的位址(0x…)、距離、群號和中心,都取自同一次實際執行(Python 3.13.7,random.seed(3))。位址每次執行都不同。
is 都是 True)。distances.index(min(distances)) 交回什麼?四個選項都是分群演算法,最後也都會給每個點一個群號;差別在怎麼決定誰和誰一群。下表的最後一列,是 scikit-learn 1.8.0 在這 12 間店上實際分出來的結果。
| A|K-means | B|GMM | C|階層式 | D|DBSCAN | |
|---|---|---|---|---|
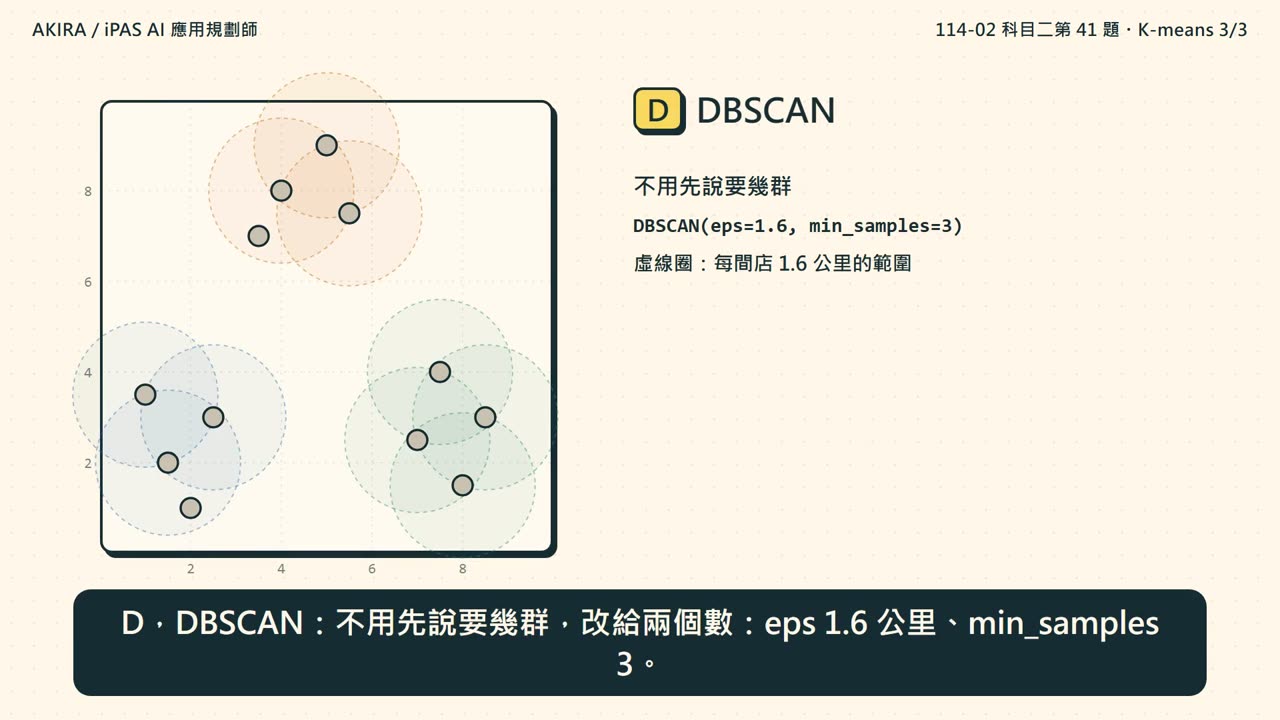
| 群數要先給嗎 | 要(X) | 要(幾個常態分佈) | 可以最後再決定(切樹狀圖) | 不用,改給距離 eps 和最少點數 |
| 每一群用什麼代表 | 一個中心點(平均) | 一個鐘形分佈:平均+形狀(共變異數) | 沒有中心;看合併的過程 | 沒有中心;看哪裡夠密 |
| 一個點屬於幾群 | 只屬於最近的一群 | 屬於每一群都有一個機率 | 一群 | 一群,或是雜訊(−1) |
| 怎麼算出來 | 分給最近中心 ↔ 中心搬到平均,反覆到不動 | 算機率 ↔ 更新平均與形狀,反覆(EM 演算法) | 一開始每點自成一群,每次合併最接近的兩群 | 從密集的點往外擴張,連得到的就是一群 |
| 12 間店的結果 | 西南、東邊、北邊各 4 間 | 一樣 | 一樣 | 一樣 |
| 多一間偏遠的店 (9.5, 9.5) | 硬塞進北邊那群,中心被拉到 (5.5, 8.2) | 也塞進北邊那群 | 也併進北邊那群 | 標成雜訊 −1 |
資料分得很開的時候,四種方法的結果可能一模一樣,所以不能只看結果認演算法,要看做法。虛擬碼寫的「指派給最近的中心」「中心更新為平均值」「中心不再變動時停止」,只有 K-means 是這樣做的。GMM 也是兩個步驟反覆,但每個點分給每一群的是機率(軟分群),而且每群除了平均還要學形狀;新店 (5, 4) 在 GMM 裡屬於東邊那群的機率是 0.9986,不是「直接指派」。
KMeans(實測 1.8.0)KMeans(n_clusters=8, *, init='k-means++', n_init='auto', max_iter=300, tol=0.0001,
verbose=0, random_state=None, copy_x=True, algorithm='lloyd')
| 參數/屬性 | 預設值或意思 | 對應虛擬碼 |
|---|---|---|
n_clusters | 8(一定要自己改) | X(要分成的群數) |
init | 'k-means++':第一個中心隨機挑,之後離已選中心越遠的點越容易被挑中;設 'random' 就是虛擬碼的「隨機選 X 個點」 | 步驟 1 |
n_init | 'auto':init 是 k-means++ 時跑 1 次,是 'random' 時跑 10 次,留下總和最小的 | 虛擬碼只跑 1 次 |
max_iter、tol | 最多 300 輪;中心移動量小於門檻就算收斂 | 步驟 3「不再變動」 |
algorithm='lloyd' | 就是「分群 ↔ 更新中心」輪流做的經典版本 | 步驟 2a、2b |
.labels_、.cluster_centers_ | 每個點的群號、每群的中心 | Output 的 clusters、centroids |
.inertia_、.n_iter_ | 距離平方總和、跑了幾輪 | (虛擬碼沒有輸出) |
實測:給它和本頁 Python 一樣的起點 (1, 3.5)、(5, 9)、(4, 8),n_init=1,結果 labels_、cluster_centers_ 完全相同,n_iter_ 是 4、inertia_ 是 14.125。用預設的 k-means++,只跑 2 輪就到同樣的 14.125。
隨機挑的起點可能卡在壞答案(100 個種子有 9 個,總和 84.7~87.75)。實務上用 k-means++,或跑好幾次留最好的(n_init)。
某一群在分群後一個點都沒有,平均就要「除以 0」。§4 的 160 組起點裡有 5 組會這樣,§3 的程式會出錯;scikit-learn 會把空的中心改放到別的點上。
K-means 不會告訴你該分幾群。X 越大總和一定越小,常見做法是畫出「X 對總和」的曲線,找轉折點(手肘法)。
考卷只有虛擬碼,左邊是本頁照著它逐步翻譯的 Python(第 5~16 行右邊的註解標著對應的步驟)。只用 Python 內建的 math 和 random,不用安裝任何套件;完整可以執行的版本在 §6 程式 1。點任一行可以跳到解說;右邊往下捲時,左邊會自動標出目前講到哪一行。
兩個都是 Python 內建的標準函式庫,不用另外安裝。
import mathmath.dist。import randomrandom.sample(隨機挑)和 random.seed(固定亂數)。定義一台叫 kmeans 的機器,對應虛擬碼的 Input。Output 有兩樣(clusters、centroids),由最後的 return 一起交回。
data_points(x, y):N=12、D=2。X從 12 間店裡隨機挑 3 間(不重複),它們的位置就是 3 個中心的起點。
random.sample(data_points, X)random.seed(3) 固定亂數,結果才能重現。換成 random.seed(7) 會挑到 (8, 1.5)、(2.5, 3)、(8.5, 3),最後卡在壞答案(觀念 5)。不知道要幾輪,就先「一直重複」,等第 16~17 行發現中心不動了,再用 break 跳出。
while True:break。每一輪先清出一個空的 clusters,再對每間店:量它到 3 個中心的距離,找出最小的那個在第幾號,就是它的群號。
[math.dist(p, c) for c in centroids]min(distances)distances.index(…)對每一群:用 zip 把「店」和「它的群號」配成一對對,留下群號是 k 的店,x、y 各自取平均,就是新的中心。
zip(data_points, clusters)((1.5, 2), 0)、((2, 1), 0)…sum(x for x, y in members) / len(members)len(members) 是 0,這一行會出錯 ZeroDivisionError。虛擬碼沒說這時怎麼辦(§2「空群」)。新算出來的中心和這一輪開始時一模一樣,就代表沒有店換組、中心也不必再搬:跳出 while 迴圈。
new_centroids == centroids(1, 3.5) == (1.0, 3.5) 也是 True。breakcentroids 這個名字改指向新的清單,回到第 6 行再做一次分群和更新。
一次交回兩樣東西(Python 會把它們包成一個 tuple),對應虛擬碼的兩個 Output。
準備資料,固定亂數種子,呼叫 kmeans;交回的兩樣東西用兩個名字接住。
random.seed(3)random.sample 每次都挑到同樣的 3 間。clusters, centroids = …西南 4 間是第 0 群、北邊 4 間是第 1 群、東邊 4 間是第 2 群。群號只是編號,換一個起點,同樣的分法可能叫做不同的號碼(scikit-learn 預設就把東邊叫第 0 群)。
實驗 1 用 JavaScript 照 §3 的 Python 即時計算(距離用和 Python 的 math.dist 同樣的算法,算到最後一位都一樣)。起點是事先用 Python 的 random.sample 抽好的:X=2~5、種子 0~19、有沒有偏遠的店,共 160 組。本頁用 Node.js 跑同一段計算程式,從這 160 組起點一路跑到收斂,和 Python 3.13.7 實際執行的每一輪中心、分群、總和比對了 1,066 個結果,全部一致。實驗 2 的每一種分法,是事先用 scikit-learn 1.8.0 實際算出來的。
① 按「考卷情境」,交替按 a、b:第 1 輪東邊有 2 間店被分到西南的中心,中心一路往東拉,第 3 輪東邊 4 間才回到同一群,第 4 輪中心不動,停止。② 按「種子 7」:兩個中心都在東邊,按兩輪就停了,總和 87.25,比 14.125 大很多:停下來不代表最好。③ 按「加偏遠的店」:(9.5, 9.5) 被分進北邊那群,北邊的中心被拉到 (5.5, 8.2)。④ 把 X 拉到 4、5,總和繼續變小,但多出來的群只是把原本的區域再切開。⑤ 有幾組起點會出現「某一群一個點都沒有」,這時 §3 的程式會在平均那一行除以 0。
12 間店分得很開,四種方法的答案都一樣;所以考題給的是做法,不是結果。K-means 用「最近的中心+平均」;GMM 用「機率+鐘形分佈」(橢圓是每群的形狀);階層式用「一路合併」(看下面的合併順序);DBSCAN 用「夠不夠密」,偏遠的店因為附近 1.6 公里內不到 3 間店,被標成雜訊,其他三種方法都把它硬塞進某一群。
§2 的表格比較了四種分群法,實驗 2 讓你切換著看。動畫 3 在同一張地圖上,把四個選項一個一個演出來:K-means 的中心和 k-means++、GMM 的橢圓和機率、階層式的合併順序、DBSCAN 的範圍圈,最後加一間偏遠的店,看誰把它當成雜訊。
帶著三個問題看:① GMM 和 K-means 最大的差別是什麼?② 階層式為什麼切在 3 群?③ 偏遠的店在 K-means 和 DBSCAN 裡各怎樣?
每一種分法、GMM 的橢圓與機率、階層式的合併距離、DBSCAN 的核心點,都是 scikit-learn 1.8.0(SciPy 1.16.2)在這 12 間店上實際算出來的。顏色照區域上(西南藍、北邊橘、東邊綠),因為各方法的群號編法不同。
先把虛擬碼的每一步,拿去問四種方法「你有沒有做這件事」:
| 虛擬碼的步驟 | A K-means | B GMM | C 階層式 | D DBSCAN |
|---|---|---|---|---|
| 先給群數 X | 有 | 有 | 可以不用 | 不用 |
| 隨機選 X 個點當初始中心 | 有 | 平均+形狀 | 沒有中心 | 沒有中心 |
| 每個點指派給最近的中心(只屬一群) | 有 | 給機率 | 合併 | 看密度 |
| 中心更新為群的平均值,重複到不再變動 | 有 | 還要更新形狀、權重 | 不反覆 | 不反覆 |
虛擬碼的每一步都是 K-means 的定義:隨機選 X 個中心(步驟 1)、每個點分給最近的中心(2a)、中心改成群的平均(2b)、重複到中心不動(3)。X 就是 K,「平均」就是 means。照它翻成的 Python 和 scikit-learn 的 KMeans(init=同樣的起點, n_init=1) 在 12 間店上結果完全相同,都是 4 輪、總和 14.125。
GMM 假設每一群是一個鐘形(常態)分佈,有自己的平均和形狀(共變異數)。它也是兩步驟反覆(EM 演算法),但第一步算的是「每個點屬於每一群的機率」,不是直接指派給最近的中心;第二步除了平均,還要更新形狀和每群的比重。實測新店 (5, 4) 屬於東邊那群的機率是 0.9986,其他兩群合起來 0.0014。虛擬碼是「非此即彼」的指派,所以不是它。
階層式(scikit-learn 的 AgglomerativeClustering,預設 linkage='ward')一開始每個點自成一群,每一步把「合併後增加的變異最少」的兩群合在一起,一路合到剩下要的群數,過程可以畫成樹狀圖。它沒有初始中心、沒有隨機、也不用「重複到收斂」。
DBSCAN 不用先說要幾群,改給兩個數:多近算鄰居(eps,本頁 1.6 公里)、至少幾個鄰居才算「密集」(min_samples,本頁 3)。從密集的點往外擴張,連得到的就是一群;連不到的點標成雜訊 −1。實測加一間偏遠的店 (9.5, 9.5),DBSCAN 把它標成 −1,K-means 卻把它塞進北邊那群。DBSCAN 沒有中心、沒有平均。
| 虛擬碼或題目出現的關鍵動作 | 演算法 |
|---|---|
| 選 K 個中心 → 每點指派給最近的中心 → 中心改成平均 → 重複到不再變動 | K-means |
| 每點屬於每群的機率、常態分佈、平均與共變異數、EM(E 步驟、M 步驟) | GMM(高斯混合模型) |
| 每點自成一群 → 每次合併最近的兩群 → 樹狀圖(dendrogram) | 階層式分群 |
| eps、min_samples、核心點、密度可達、雜訊(noise) | DBSCAN |
| 錯誤想法 | 實際上 |
|---|---|
| K-means 的 K 和 KNN 的 K 一樣 | K-means 的 K 是「分幾群」(非監督式);KNN 的 K 是「問幾個鄰居」(監督式分類,第 40 題 115 年那一題)。 |
| K-means 停下來就是最好的分法 | 只代表「中心不再動」。起點不好會卡在壞答案:種子 7 停在 87.25,好的分法是 14.125。 |
| 結果一樣,演算法就一樣 | 這 12 間店四種方法分得一模一樣;要看做法:中心+平均+最近才是 K-means。 |
| K-means 會自動排除離群點 | 不會。每個點都一定被分進某一群,偏遠的店還會把中心拉走;能標出雜訊的是 DBSCAN。 |
| 群號 0、1、2 有固定意義 | 群號只是編號。§3 的結果西南是第 0 群;scikit-learn 預設的結果,西南是第 2 群。 |
程式 1 只用 Python 本身,裝好 Python 就能跑。程式 2、3 用到 scikit-learn 和 NumPy,要先安裝:pip install scikit-learn(Google Colab 已經內建,直接貼上就能跑)。
import math
import random

def kmeans(data_points, X):
    centroids = random.sample(data_points, X)                  # 1
    rnd = 0
    while True:                                                # 2
        clusters = []                                          # 2a 分群
        for p in data_points:
            distances = [math.dist(p, c) for c in centroids]
            clusters.append(distances.index(min(distances)))
        new_centroids = []                                     # 2b 更新中心
        for k in range(X):
            members = [p for p, c in zip(data_points, clusters) if c == k]
            new_centroids.append((sum(x for x, y in members) / len(members),
                                  sum(y for x, y in members) / len(members)))
        rnd += 1
        print(f'第 {rnd} 輪:中心 {[(round(x, 2), round(y, 2)) for x, y in centroids]} → 分群 {clusters}')
        if new_centroids == centroids:                         # 3
            break
        centroids = new_centroids
    return clusters, centroids

# 12 間店在地圖上的位置(公里)
stores = [(1.5, 2), (2, 1), (2.5, 3), (1, 3.5), (7, 2.5), (8, 1.5),
          (8.5, 3), (7.5, 4), (4, 8), (5, 9), (5.5, 7.5), (3.5, 7)]
random.seed(3)
clusters, centroids = kmeans(stores, 3)
print('clusters =', clusters)
print('centroids =', centroids)
第 1 輪:中心 [(1, 3.5), (5, 9), (4, 8)] → 分群 [0, 0, 0, 0, 0, 0, 2, 2, 2, 1, 1, 2]
第 2 輪:中心 [(3.67, 2.25), (5.25, 8.25), (5.88, 5.5)] → 分群 [0, 0, 0, 0, 2, 0, 2, 2, 1, 1, 1, 1]
第 3 輪:中心 [(3.0, 2.2), (4.5, 7.88), (7.67, 3.17)] → 分群 [0, 0, 0, 0, 2, 2, 2, 2, 1, 1, 1, 1]
第 4 輪:中心 [(1.75, 2.38), (4.5, 7.88), (7.75, 2.75)] → 分群 [0, 0, 0, 0, 2, 2, 2, 2, 1, 1, 1, 1]
clusters = [0, 0, 0, 0, 2, 2, 2, 2, 1, 1, 1, 1]
centroids = [(1.75, 2.375), (4.5, 7.875), (7.75, 2.75)]
和 §3 的程式相比,只多了數輪數的 rnd(第 6、17 行)、每一輪的 print(第 18 行)、店家位置的註解(第 24 行),最後印出時加了名字。印出的中心四捨五入到小數 2 位。
import numpy as np
from sklearn.cluster import KMeans

stores = np.array([(1.5, 2), (2, 1), (2.5, 3), (1, 3.5), (7, 2.5), (8, 1.5),
                   (8.5, 3), (7.5, 4), (4, 8), (5, 9), (5.5, 7.5), (3.5, 7)])

# 和程式 1 一樣的起點:(1, 3.5)、(5, 9)、(4, 8),只跑 1 次
same = KMeans(n_clusters=3, init=np.array([(1, 3.5), (5, 9), (4, 8)]), n_init=1).fit(stores)
print('同樣的起點:labels_ =', same.labels_.tolist())
print('            cluster_centers_ =', same.cluster_centers_.tolist())
print('            n_iter_ =', same.n_iter_, '|inertia_ =', same.inertia_)

# 壞的起點:(8, 1.5)、(2.5, 3)、(8.5, 3)
bad = KMeans(n_clusters=3, init=np.array([(8, 1.5), (2.5, 3), (8.5, 3)]), n_init=1).fit(stores)
print('壞的起點:labels_ =', bad.labels_.tolist(), '|inertia_ =', bad.inertia_)

# 預設:init='k-means++'
model = KMeans(n_clusters=3, random_state=0).fit(stores)
print('預設 k-means++:labels_ =', model.labels_.tolist(), '|n_iter_ =', model.n_iter_, '|inertia_ =', model.inertia_)
print('新店 (5, 4) 屬於群', model.predict([(5, 4)])[0])
同樣的起點:labels_ = [0, 0, 0, 0, 2, 2, 2, 2, 1, 1, 1, 1]
            cluster_centers_ = [[1.75, 2.375], [4.5, 7.875], [7.75, 2.75]]
            n_iter_ = 4 |inertia_ = 14.125
壞的起點:labels_ = [1, 1, 1, 1, 0, 0, 2, 2, 1, 1, 1, 1] |inertia_ = 87.25
預設 k-means++:labels_ = [2, 2, 2, 2, 0, 0, 0, 0, 1, 1, 1, 1] |n_iter_ = 2 |inertia_ = 14.125
新店 (5, 4) 屬於群 0
同樣的起點:群號、中心和程式 1 完全一樣,n_iter_ 也是 4。壞的起點:東邊切成兩群(群號 0、2),西南和北邊被湊成第 1 群,總和 87.25。預設的 k-means++ 只跑 2 輪就到 14.125,群號的編法不同(東邊是第 0 群);新店 (5, 4) 離東邊的中心 3.02 公里,最近,所以是第 0 群。
import numpy as np
from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN
from sklearn.mixture import GaussianMixture

stores = np.array([(1.5, 2), (2, 1), (2.5, 3), (1, 3.5), (7, 2.5), (8, 1.5),
                   (8.5, 3), (7.5, 4), (4, 8), (5, 9), (5.5, 7.5), (3.5, 7)])

print('A K-means:', KMeans(n_clusters=3, random_state=0).fit(stores).labels_.tolist())
gmm = GaussianMixture(n_components=3, random_state=0).fit(stores)
print('B GMM:    ', gmm.predict(stores).tolist())
print('   新店 (5, 4) 屬於各群的機率:', np.round(gmm.predict_proba([(5, 4)])[0], 4).tolist())
print('C 階層式:  ', AgglomerativeClustering(n_clusters=3).fit(stores).labels_.tolist())
print('D DBSCAN:  ', DBSCAN(eps=1.6, min_samples=3).fit(stores).labels_.tolist())

# 多一間偏遠的店 (9.5, 9.5)
more = np.vstack([stores, [(9.5, 9.5)]])
km = KMeans(n_clusters=3, random_state=0).fit(more)
print('加一間偏遠的店:')
print('  K-means:', km.labels_.tolist(), '中心', np.round(km.cluster_centers_, 2).tolist())
print('  DBSCAN: ', DBSCAN(eps=1.6, min_samples=3).fit(more).labels_.tolist())
A K-means: [2, 2, 2, 2, 0, 0, 0, 0, 1, 1, 1, 1]
B GMM:     [2, 2, 2, 2, 0, 0, 0, 0, 1, 1, 1, 1]
   新店 (5, 4) 屬於各群的機率: [0.9986, 0.0014, 0.0]
C 階層式:   [0, 0, 0, 0, 2, 2, 2, 2, 1, 1, 1, 1]
D DBSCAN:   [0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2]
加一間偏遠的店:
  K-means: [2, 2, 2, 2, 0, 0, 0, 0, 1, 1, 1, 1, 1] 中心 [[7.75, 2.75], [5.5, 8.2], [1.75, 2.38]]
  DBSCAN:  [0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2, -1]
四種方法分出來的三群完全一樣,只是群號的編法不同。GMM 交回的是機率。加了偏遠的店之後,K-means 把它分進北邊那群(第 1 群),北邊的中心從 (4.5, 7.88) 被拉到 (5.5, 8.2);DBSCAN 把它標成 −1(雜訊)。
| 新出現的語法 | 是什麼 | 白話 |
|---|---|---|
random.seed(3)、random.sample(清單, X) | 函式 | 固定亂數;隨機挑 X 個不重複的元素 |
while True: … break | 迴圈 | 一直重複,直到 break 跳出 |
清單.index(min(清單)) | 方法+內建函式 | 最小值在第幾號 |
zip(a, b) | 內建函式 | 兩個清單一格一格配成對 |
KMeans(n_clusters=3, init=…, n_init=1) | scikit-learn 類別 | K-means;.labels_、.cluster_centers_、.inertia_、.n_iter_ |
GaussianMixture(n_components=3) | scikit-learn 類別 | GMM;.predict_proba() 交回屬於每一群的機率 |
AgglomerativeClustering(n_clusters=3) | scikit-learn 類別 | 階層式分群(預設 ward 合併) |
DBSCAN(eps=1.6, min_samples=3) | scikit-learn 類別 | 密度分群;雜訊的群號是 −1 |
np.vstack([a, b]) | NumPy 函式 | 把列疊起來(多加一間店) |
random.sample 挑起點、math.dist 量距離、index(min(...)) 找最近、zip 收集同群、while True + break 重複到收斂。while True: 一直重複,在迴圈裡 if new_centroids == centroids: break,中心不變就跳出。len(members) 是 0,出錯 ZeroDivisionError。虛擬碼沒有規定這種情況。每一頁都把考古題的程式一行一行拆開:記憶體裡發生什麼、每個選項各算出什麼,配旁白動畫。完整版還有: